AI News
  • Teknoloji Haberleri
  • İnceleme
  • Mobil
  • Nasıl Yapılır
  • Otomobil
  • Oyun
  • Yazılım
  • Yapay Zeka
No Result
View All Result
AI News
  • Teknoloji Haberleri
  • İnceleme
  • Mobil
  • Nasıl Yapılır
  • Otomobil
  • Oyun
  • Yazılım
  • Yapay Zeka
No Result
View All Result
AI News
No Result
View All Result
Yapay zekâ komut paketlerinin parser kapılarından geçerken parçalandığını gösteren özgün editoryal görsel

QuoteBench, doğru üretilen komutların alıntı işaretleri ve ayrıştırma katmanlarından geçerken nasıl parçalanabildiğini ölçüyor.

Yapay Zekâ Komutu Doğru Yazdı ama Sistem Bozdu: QuoteBench Ne Gösteriyor?

Ağustos 15, 2026
in Yapay Zeka
0
585
SHARES
3.3k
VIEWS
ChatGPT ile özetleyinFacebook'ta paylaş

Bir yapay zekâ ajanı terminal komutunu doğru üretebilir, fakat komut çalıştırma aracına ulaşana kadar tırnak işaretleri, kaçış karakterleri veya JSON katmanı tarafından değiştirilebilir. Sonuçta model mantıken doğru cevabı verirken sistem yanlış komutu çalıştırır. 13 Ağustos 2026’da yayımlanan QuoteBench çalışması, çoğu kıyaslamanın gözden kaçırdığı bu taşıma katmanını ayrı bir güvenilirlik problemi olarak ölçüyor.

Araştırmanın önemli yanı, hatayı yalnızca “model başarısız oldu” diye etiketlememesi. Model çıktısı, aracı çağıran protokol, ayrıştırıcı ve çalıştırma ortamı ayrı ayrı ele alınıyor. Böylece bir ajanın başarısı ile modelin gerçek komut yazma becerisi arasındaki fark görülebiliyor. Bu ayrım; kodlama asistanı, sunucu otomasyonu ve güvenlik aracı geliştiren ekipler için doğrudan pratik değer taşıyor.

QuoteBench Nasıl Kuruldu?

Çalışmada gerçek olaylardan türetilen 14 hata ailesine yayılan 56 tek atımlık görev kullanıldı. Görevler; iç içe tırnak, boşluk, değişken genişletme, özel karakter ve kabuk sözdizimi gibi komutun katmanlar arasında değişmesine yol açabilecek durumları kapsıyor. Araştırmacılar sekiz farklı model-sistem yapılandırmasını hem doğrudan hem de ek bir parser üzerinden test etti.

Bir görev yalnızca komut metninin güzel görünmesiyle başarılı sayılmıyor. Nihai çalıştırılan komutun beklenen davranışı üretmesi gerekiyor. Bu yaklaşım, bir mesajın model ekranında doğru görünmesine rağmen JSON veya kabuk katmanında farklı yorumlanmasını yakalıyor. Deney ayrıca modele taşıma biçimi açıkça anlatıldığında sonucun ne kadar düzeldiğini ölçüyor.

Başarı Neden 73,2 Puana Kadar Düştü?

Ek parser katmanı, incelenen yapılandırmalarda görev başarısını 55,4 ile 73,2 yüzde puanı arasında düşürdü. Buradaki değer göreli yüzde değil, doğrudan başarı oranındaki puan kaybı. Bu kadar büyük fark, ajanın “zekâsından” bağımsız görünen bir entegrasyon ayrıntısının bütün sistemi kullanılamaz hale getirebileceğini gösteriyor.

Problemin temelinde bir metnin birden fazla kez yorumlanması var. Model kabuk için tırnak ekliyor; istemci bunu JSON içinde kaçırıyor; sunucu parser’ı yeniden çözüyor; en sonunda kabuk başka bir anlam çıkarıyor. Her katman kendi içinde doğru görünse de birleşik zincir komutu bozabiliyor. Özellikle kullanıcı girdisini komuta ekleyen sistemlerde bu durum yalnızca hata değil, güvenlik riski de oluşturabilir.

Taşıma Biçimini Modele Anlatmak İşe Yarıyor mu?

Araştırmacılar modele, çıktının hangi parser ve taşıma yolundan geçeceğini açıkladığında altı yapılandırmada 30,4 ile 60,7 puan arasında iyileşme gördü. Yani model, gerçek çalışma ortamını bildiğinde kaçış ve tırnak stratejisini uyarlayabiliyor. Ancak iki yapılandırmada iyileşme sıfıra yakın veya hafif negatif kaldı. Tek bir “sistem istemine parser’ı yaz” çözümü her model ve araç için güvenilir değil.

Daha ilginç sonuç, toplam puanın bazı ayrıntıları gizlemesi. GPT-5.6-sol yapılandırmasında eşleştirilmiş toplam fark yalnızca eksi 3,6 puan görünürken bunun altında 64,3 puanlık hasar ile 60,7 puanlık telafi aynı anda bulunuyor. Yalnızca son ortalamaya bakıldığında sistem kararlı sanılabilir; aslında iki büyük etkinin birbirini iptal ettiği görülüyor.

Model Sıralaması Bile Değişebilir

26 model çifti karşılaştırmasında açık bir sıralama tersine dönmesi ve tek görev marjında dört değişim raporlandı. Bu, aynı modeller farklı komut taşıma katmanlarıyla test edildiğinde “en iyi model” sonucunun değişebileceği anlamına geliyor. Bir kıyaslama gerçek üretim protokolünü yansıtmıyorsa model seçimi yanıltıcı olabilir.

Dolayısıyla ajan değerlendirmesinde model adı, sıcaklık ve istem kadar araç protokolü de raporlanmalı. Komutun modele nasıl gösterildiği, nasıl seri hale getirildiği, hangi parser’ın kullandığı ve nihai kabuğa hangi baytların ulaştığı deneyin parçasıdır. Aksi halde hata modeli suçlarken entegrasyondan kaynaklanabilir.

Geliştiriciler Ne Yapmalı?

  • Yapılandırılmış çağrı: Mümkünse tek bir kabuk metni yerine komut ve argümanları ayrı alanlarda taşıyın.
  • Tek yorumlama: Aynı metni JSON, şablon ve kabukta art arda yeniden ayrıştırmaktan kaçının.
  • Uçtan uca test: Model çıktısını değil, nihai çalıştırılan argüman dizisini ve davranışı doğrulayın.
  • Olay tabanlı görevler: Tırnak, boşluk, Unicode ve kullanıcı girdisi içeren gerçek hata örneklerini test paketine ekleyin.
  • Gözlemlenebilirlik: Hassas bilgileri maskeleyerek ham model çıktısı ile çalıştırılan komut arasındaki dönüşümü kaydedin.
  • Yetki sınırı: Komut hatasının zararını azaltmak için ajanı düşük yetkili ve izole ortamda çalıştırın.

Çalışmanın Sınırları

QuoteBench 56 görev ve belirli sekiz yapılandırmayla sınırlı bir ön baskı. Her programlama dili, kabuk veya üretim aracını temsil etmiyor. Başarı kayıpları doğrudan bütün yapay zekâ ajanlarına genellenemez. Buna rağmen çalışma, araç kullanan modellerde güvenilirliğin yalnızca doğru akıl yürütme olmadığını somut sayılarla gösteriyor.

Almadanincele Yorumu

QuoteBench’in en değerli mesajı basit: ekranda doğru görünen komut, çalışan sistemde doğru komut olmayabilir. Yapay zekâ ajanlarında kaliteyi yalnızca model cevabıyla ölçmek, kargoya sağlam verilen fakat aktarım sırasında kırılan ürünü üretici hatası saymaya benziyor. Taşıma zinciri de ürünün kendisi kadar test edilmeli.

Bizce üretim sistemlerinde temel kural, kabuğa serbest metin göndermek yerine komut ve argümanları yapılandırılmış biçimde taşımak olmalı. Modelin parser’ı bilmesi yardımcı olabilir, fakat güvenlik sınırı olarak yeterli değil. Uçtan uca test, düşük yetki ve nihai komut denetimi birlikte uygulanmadıkça daha güçlü model yalnızca daha hızlı hata üretebilir.

Kapak görseli: Almadanincele / OpenAI ImageGen özgün editoryal görsel. Kullanım bilgisi: Almadanincele için OpenAI ImageGen ile özgün üretilmiştir.

Kaynaklar

  • QuoteBench araştırması – arXiv
  • QuoteBench açık erişimli tam metin
Tags: Komut SatırıLLM GüvenilirliğiParserQuoteBenchYapay Zeka Ajanları
SummarizeShare234
Previous Post

Google Home Speaker 2026 İncelemesi: Gemini, 360 Derece Ses ve Abonelik Dengesi

Next Post

Yapay Zekâ Ajanı Pratik Yaptıkça Tehlikeli Hale Gelebilir mi? Yeni Testin Sonucu

Almadanincele Editör Ekibi

Almadanincele Editör Ekibi

Almadan İncele editör ekibi; teknoloji, yapay zeka, mobil, oyun, otomobil ve yazılım dünyasındaki gelişmeleri satın alma kararı odaklı, anlaşılır ve kaynaklı şekilde değerlendirir.

İlgili Haberler

Konuşma dalga biçimi ve gerçek zamanlı yazıya döküm fikrini anlatan özgün editoryal görsel

Microsoft’tan Anlık Konuşma Çözümleme: Yeni MAI Modelleri 60 Dili Destekliyor

by Almadanincele Editör Ekibi
Ekim 2, 2026
0

Microsoft’un 1 Ekim’de duyurduğu MAI-Transcribe-2-Streaming, 60 dilde konuşma sürerken metin üretiyor; MAI-Voice 2.1 ailesi 23 dil ve 26 yerel seçeneğe odaklanıyor.

Kurum içi sunucu altyapısı üzerinde çalışan yazılım geliştirme yapay zekâsını anlatan özgün editoryal illüstrasyon

IBM Bob Kurum İçi Kuruluma Açılıyor: Hassas Kodlar Bulutta Kalmak Zorunda Değil

by Almadanincele Editör Ekibi
Ekim 2, 2026
0

IBM, Bob yazılım geliştirme platformunun kurumların kendi sunucularında, özel veya egemen bulutta ve internetten yalıtılmış ortamlarda çalışabilecek dağıtım seçeneğini duyurdu.

Google DeepMind’in SynthID Bio duyurusundaki protein yapılarının biyolojik filigranla işaretlenmesini anlatan görsel

SynthID Bio: Google, Yapay Zekâyla Tasarlanan Proteinlere Biyolojik Filigran Ekliyor

by Almadanincele Editör Ekibi
Ekim 1, 2026
0

Google DeepMind, yapay zekâyla tasarlanan protein dizilerine ve üç boyutlu yapılara algılanamaz işaret ekleyen bir kavram kanıtı yayımladı. Laboratuvar sonuçları, açık kaynak planı ve çözülmemiş riskler.

Gemini 4 Argon’un siber güvenlik odağını anlatan özgün editoryal görsel: kod ve tehdit grafiğiyle donatılmış güvenlik operasyon merkezi

Google Gemini 4 Argon’u Tanıttı: Kodlama ve Siber Güvenlikte Yeni Model, Erişim Şimdilik Sınırlı

by Almadanincele Editör Ekibi
Ekim 1, 2026
0

Google’ın 30 Eylül’de duyurduğu Gemini 4 Argon, karmaşık kodlama, bilgi işi ve siber güvenlik akışlarına odaklanıyor. İlk erişim güvenlik uzmanlarıyla sınırlı; şirket iddiaları ve belirsiz noktaları ayırıyoruz.

Next Post
Güvenli başlayan ajan becerilerinin bozulup koruma katmanında düzeltildiğini gösteren özgün editoryal görsel

Yapay Zekâ Ajanı Pratik Yaptıkça Tehlikeli Hale Gelebilir mi? Yeni Testin Sonucu

Bir yanıt yazın Yanıtı iptal et

E-posta adresiniz yayınlanmayacak. Gerekli alanlar * ile işaretlenmişlerdir

Tavsiye edilen

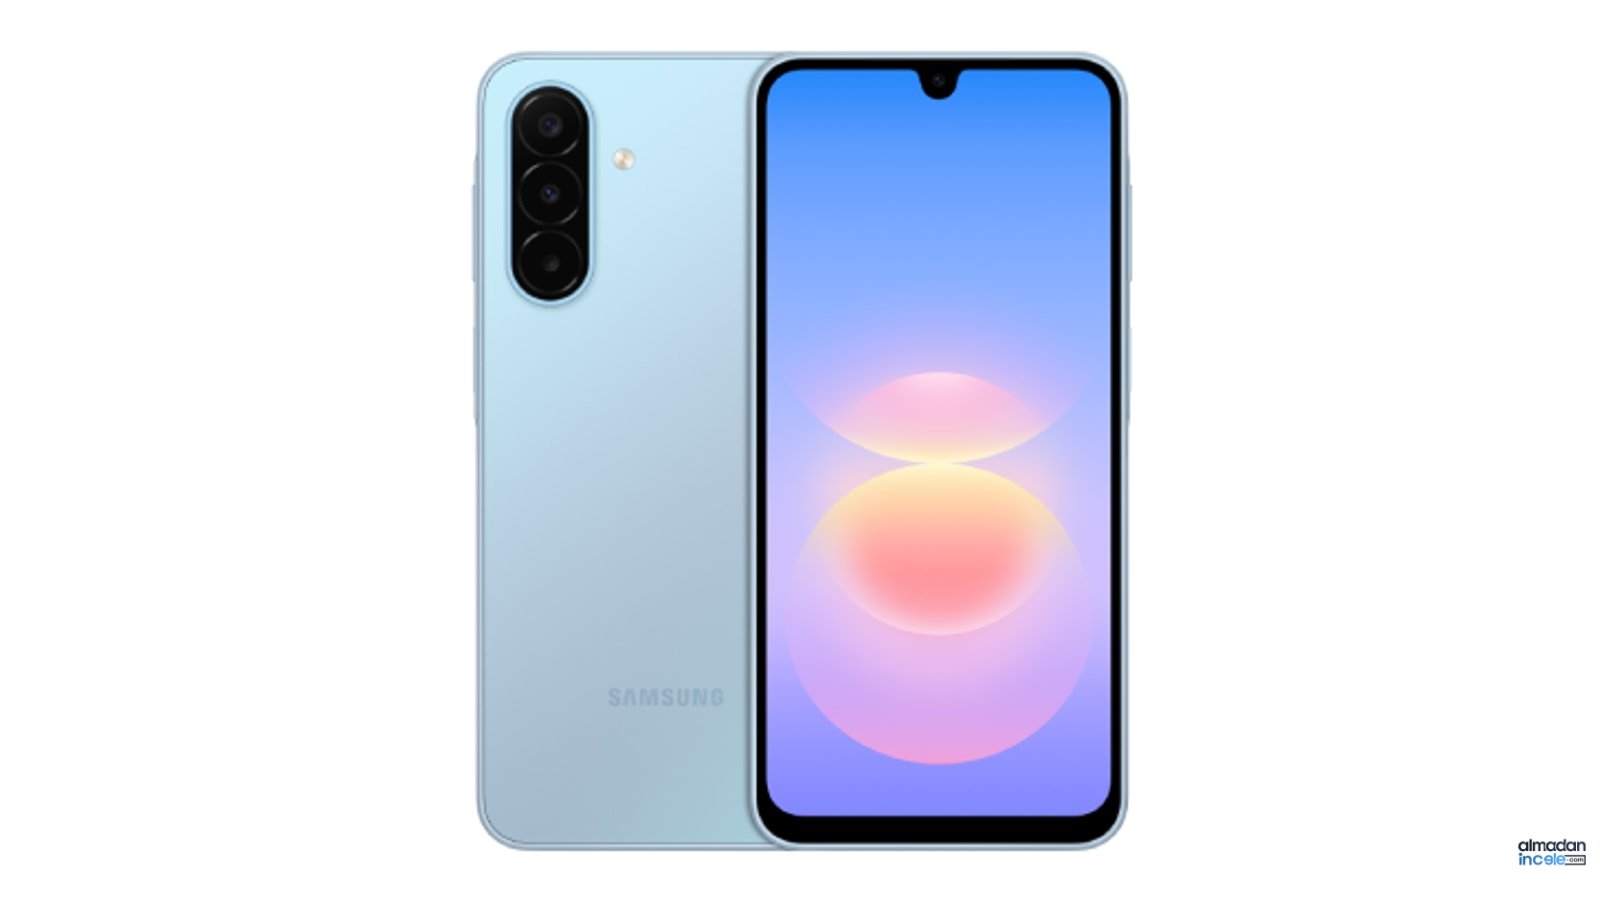
Samsung Galaxy A18 telefonun ön ve arka görünümü

Samsung Galaxy A18 Ön İncelemesi: 279 Avroluk Telefon Altı Yıl Kullanılır mı?

Eylül 17, 2026
Microsoft Surface Laptop 13 yeni nesil modeli, açık renk alüminyum gövde ve ekranı

Surface Laptop 13 Ön İncelemesi: Snapdragon X2 Plus ile Hafif Günlük Bilgisayar

Eylül 30, 2026
Toyota Land Cruiser 300 koyu renkli SUV, resmî Japonya ürün sayfası görseli

Hibrit Toyota Land Cruiser 300 Yarın Japonya’da Satışa Çıkıyor: Bilinenler ve Bilinmeyenler

Eylül 30, 2026
Stüdyo ortamında beyaz Renault Master E-Tech elektrikli kamyonet

Renault Master E-Tech Yenilendi: V2G, 87 kWh Batarya ve İş İçin Elektrik Çıkışı

Eylül 4, 2026
Leapmotor B03X elektrikli crossover resmi basın fotoğrafı

Leapmotor B03X Avrupa’da Yola Çıktı: 382 Km Menzil ve 24.900 Avroluk Fiyat Ne Sunuyor?

Eylül 20, 2026
viaim Rise kulaklıklar ve yapay zekâ tuşlu şarj kutusu

viaim Rise Ön İncelemesi: AI Agent Kulaklık Toplantıları Gerçekten İşe Dönüştürebilir mi?

Eylül 8, 2026
Galaxy Z Fold8 Ultra, Fold8 ve Flip8 modellerinin yan yana resmi fotoğrafı

Galaxy Z Fold8 Ultra, Fold8 ve Flip8 Arasında Nasıl Seçim Yapılır?

Eylül 21, 2026
Windows 11 Büyüteç yeni kontrast teması anahtarının resmi arayüz görüntüsü

Windows 11 Insider’da Büyüteç ve Bulut Kurtarma Yenilikleri: Kimler Deneyebilir?

Eylül 20, 2026
Almadan İncele

Almadan İncele; teknoloji, mobil, oyun, otomobil ve yazılım dünyasında satın almadan önce doğru karar vermenize yardımcı olan inceleme, haber ve rehber içerikleri yayınlar.

Follow us

Son Yazılar

HP ProBook 4 G2iS iş dizüstüsünün resmi basın görseli

HP ProBook 4 G2iS 14 Ön İnceleme: İş Dünyasına 120 Hz OLED Ekran

Ekim 2, 2026
HP OmniBook 5 14 dizüstü bilgisayarın açık ekranlı resmi basın fotoğrafı

HP OmniBook 5 14 Ön İnceleme: OLED Ekran ve 42 Saatlik Pil İddiası

Ekim 2, 2026

Takip

Windows bilgisayarında disk şifreleme ve kurtarma anahtarı yedeklemeyi anlatan özgün editoryal görsel

Windows 11’de BitLocker Kurtarma Anahtarı Nasıl Yedeklenir?

Ekim 2, 2026
Ev ağında yeni nesil kablosuz bağlantı ve router yerleşimini gösteren özgün editoryal illüstrasyon

Wi-Fi 7 Evde Gerçekten Fark Yaratır mı? Router Almadan Önce 7 Kontrol

Ekim 2, 2026
  • Teknoloji Haberleri
  • İnceleme
  • Mobil
  • Nasıl Yapılır
  • Otomobil
  • Oyun
  • Yazılım
  • Yapay Zeka

© 2026 almadanincele.com. Tüm hakları saklıdır.

No Result
View All Result
  • Teknoloji Haberleri
  • İnceleme
  • Mobil
  • Nasıl Yapılır
  • Otomobil
  • Oyun
  • Yazılım
  • Yapay Zeka

© 2026 almadanincele.com. Tüm hakları saklıdır.